Делает ли ИИ глупее: все исследования и цифры в одном месте
Автор: Елена Герба
Одни и те же инструменты. Опытные разработчики стали работать на 19% медленнее. Слабые консультанты — на 43% лучше. Это не ошибка измерения.
Ниже — все цифры, все источники и объяснение, почему знак разный.
Это справочная статья: на неё ссылаются остальные публикации канала там, где нужны данные. Короткая версия этого разбора — в публикации «Я знаю кунг-фу»; здесь полная, со всеми источниками. Читать подряд не обязательно, можно возвращаться за конкретной цифрой.
Почему вопрос «отупеет ли человечество» бессмысленен
Он не проверяем. «Тупость» не измеряется одним числом, «человечество» не однородно, срок не задан.
На такой вопрос отвечают и «да», и «нет», и оба ответа одинаково легко сделать убедительными. Чтобы разговор стал возможен, вопрос надо разложить на четыре: какой конкретно навык может ухудшиться, у кого, в каких задачах и при каком способе использования.
Ответы на них разные, а иногда противоположные по знаку. В этом и состоит ответ.
Что подтверждено твёрдо
Мозг закрепляет то, что делает сам. Два эффекта из учебника когнитивной психологии. Эффект тестирования: попытка вспомнить закрепляет сильнее, чем перечитывание. Эффект генерации: порождённое самим запоминается лучше готового. Отсюда прямо: готовый ответ оставляет меньше следа. Не «мозг атрофируется», а «конкретно это знание не записалось».
Ощущение понимания опережает понимание. Иллюзия глубины объяснения, описана Розенблитом и Кейлом в 2002 году: люди высоко оценивают своё понимание устройства велосипеда или дверного замка — до момента, когда их просят объяснить механизм. После попытки оценка падает. Гладкий текст эту иллюзию усиливает: беглость чтения мозг засчитывает как понимание.
Измерения: цифры расходятся по знаку
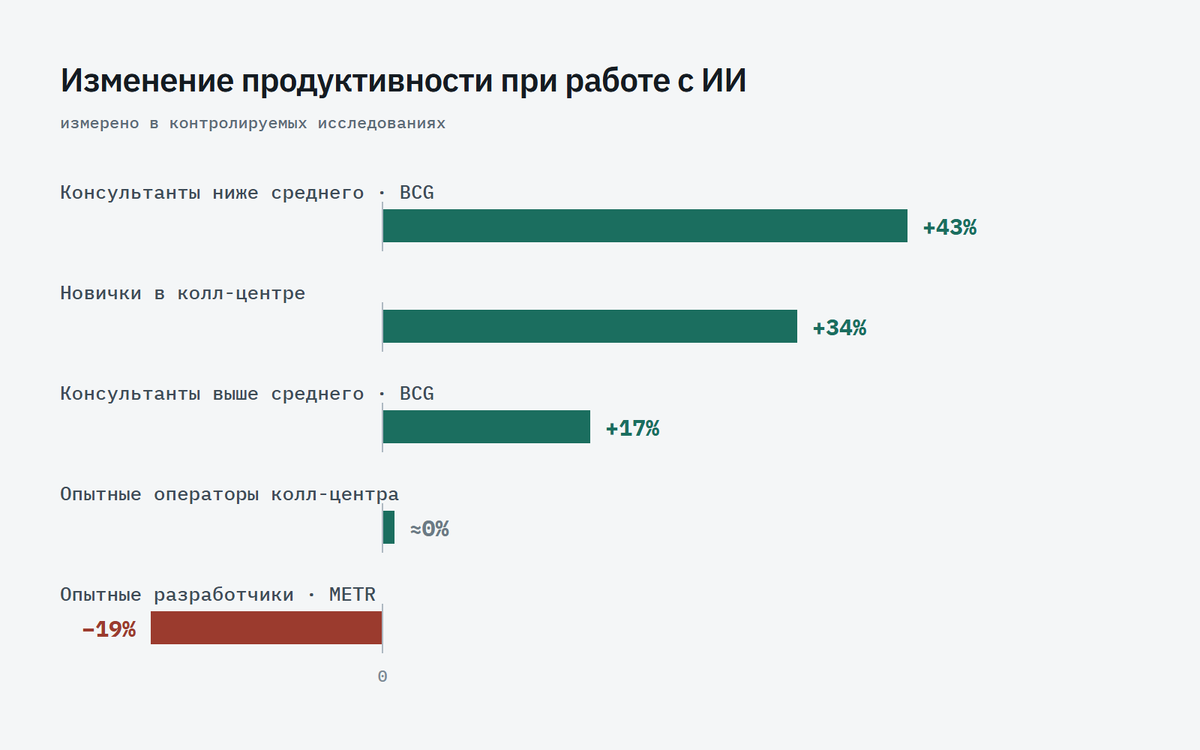
Строка, которая важнее остальных — последняя. В рандомизированном испытании METR опытные разработчики решали свои реальные рабочие задачи с ИИ-инструментами и без. С ИИ они работали на 19% медленнее и при этом были уверены, что ускорились примерно на 20%. Разрыв между ощущением и результатом — около сорока процентных пунктов.
Из этого следует не «ИИ вредит», а нечто более неудобное: самооценка перестаёт быть надёжным прибором. Человек не в состоянии заметить проблему изнутри. Аргумент «я же вижу, что стал работать лучше» здесь не работает ни у кого.
Общая картина — не спад, а сжатие разброса. ИИ сильнее помогает слабым и слабее сильным. Нижняя половина подтягивается, верхняя выигрывает мало, в отдельных случаях проигрывает. Это не то, что описывает катастрофический сценарий, но и не повод радоваться: расслоение — тоже проблема.
Три переменные, которые определяют знак
Режим использования. Оракул: спросил, получил, принял — усилия нет, своих схем не образуется. Спарринг: сделал сам, показал, получил критику, переделал — усилие сохранено, обратная связь приходит быстрее, чем раньше. Ни одно исследование не измеряет «ИИ вообще», каждое измеряет один из этих режимов.
Наличие дешёвой проверки. Где ошибка обнаруживает себя сама — код с тестами, расчёт, шахматы — ИИ скорее ускоряет рост. Где ошибка молчит годами — стратегия, управление, кадровые решения, прогнозы — там риск реальный, потому что без собственной модели проверить нечем.
Новичок или эксперт. Эксперту ИИ даёт рычаг: он знает, что спросить, и умеет проверить. Новичку может заменить ту ступеньку, на которой умение проверять формируется.
Контрпример: шахматы
В 1997 году машина обыграла действующего чемпиона мира. Предсказывали смерть игры и деградацию понимания: зачем думать, если движок посчитает.
Случилось обратное. Поколение, выросшее на движках, играет сильнее и точнее любого предыдущего и достигает этого раньше по возрасту.
Сработали два условия. Первое — мгновенная однозначная обратная связь. Второе — движок использовали как спарринг-партнёра: сначала своя оценка, потом сверка с машиной, потом разбор расхождения.
Шахматы не доказывают, что всё будет хорошо. Они доказывают, что сценарий не предопределён.
Настоящая проблема: ломается лестница, а не мозг
Эксперт вырастает из тысяч простых задач, доведённых до конца. Автоматизируется же в первую очередь именно простая работа — та, что была тренажёром: задачи для младших разработчиков, разбор типовых дел у юристов, первичные описания снимков у радиологов.
Возникает разрыв: спрос на старших специалистов остаётся, ступенька, по которой в них вырастали, исчезает.
Природа проблемы институциональная, а не нейрологическая. Ломается не человек — ломается устройство обучения и найма. Значит, чинится программами подготовки, требованием проверяемости, намеренным сохранением трудных задач. Само не произойдёт. Физическим законом не является.
Историческая рамка
Тревога не новая. Сократ в платоновском «Федре» говорил, что письменность породит забвение. По факту он был прав — способность держать в голове длинные тексты ушла. По выводу неправ — мышление не рухнуло.
Ближе пример, где тревога подтвердилась измеримо: спутниковая навигация. Постоянное использование пошаговых подсказок связано с ухудшением пространственной ориентации.
И противоположный: калькуляторы. Навык счёта в столбик упал, математическое образование сместилось на уровень выше.
Общий урок: инструмент убирает конкретный навык, а не «интеллект вообще».
Что делать практически
1. Сначала своя версия, потом ИИ. Даже плохая — ошибиться и увидеть где, это и есть механизм обучения.
2. Просить критику своего ответа, а не готовый ответ. «Вот моя логика, найди дыры» и «объясни мне» дают похожий текст и разный результат.
3. Периодически проверять себя без ИИ. Воспроизвести цепочку по памяти, изменить посылку. Не получается — было чтение, а не понимание.
4. Различать задачи «сделать» и «научиться». Делегировать то, чему не собираетесь учиться, — разумно.
5. Где нет быстрой проверки — требовать источники. Внутренней сигнализации там нет ни у кого.
Границы: чего мы не знаем
Данных мало, и они короткие. Большинство исследований — от нескольких недель до нескольких месяцев, часто на студентах, часть остаётся препринтами без рецензирования. Долгосрочных эффектов на горизонте десяти лет и на масштабе популяции не измерял никто: времени не прошло.
Отсюда следует неудобное: любое уверенное утверждение в обе стороны — и «катастрофа неизбежна», и «всё будет прекрасно» — сказано за пределами данных.
Уверенно поддерживается одно: знак эффекта разный в разных условиях, и условия известны. Этого достаточно, чтобы действовать, и недостаточно, чтобы пророчествовать.
Источники
Rozenblit & Keil (2002) — «The misunderstood limits of folk science: an illusion of explanatory depth», Cognitive Science. Иллюзия глубины объяснения.
METR (2025) — рандомизированное контролируемое испытание: 16 опытных разработчиков открытого кода, 246 реальных задач. Замедление на 19% при уверенности в ускорении.
Brynjolfsson, Li & Raymond — «Generative AI at Work». Колл-центры: около +14% в среднем, наибольший прирост у наименее опытных.
Dell'Acqua и соавт. (2023) — «Navigating the Jagged Technological Frontier», полевой эксперимент BCG и Гарвардской школы бизнеса. +43% у слабых, +17% у сильных.
Noy & Zhang (2023), Science — письменные задачи: рост качества при сокращении разрыва между слабыми и сильными.
Roediger & Karpicke — эффект тестирования. **Slamecka & Graf** — эффект генерации.
Dahmani & Bohbot (2020), Scientific Reports — связь стажа использования GPS с ухудшением пространственной памяти.
Этот текст написан ИИ. Проверьте цифры по источникам — в этом весь смысл канала.
#искусственныйинтеллект #исследования #нейросети
Оригинал на Дзене: https://dzen.ru/a/aqJBqNu_VAL88CW8